AIDEFEND in Action AIA-0013 實證研究 發布於 AIA: 2026年4月25日

Apple Intelligence 本機模型遭提示詞注入:app 資料與功能被帶偏的風險

RSAC 研究人員結合 Neural Exec(能誘導模型執行指定任務的對抗輸入)與 Unicode 由右至左覆寫控制字元(right-to-left override,RLO),繞過 Apple Intelligence 本機 LLM 的輸入、輸出過濾與內部防護。研究在 100 個隨機提示詞中,得到 76% 的平均攻擊成功率。Apple 已在 iOS 26.4 與 macOS 26.4 強化受影響系統;來源未發現野外利用證據。這個案例的防禦重點,是限制 app 能交給模型的資料與功能,並在實際輸入、輸出及動作位置驗證控制。

Prompt InjectionGuardrail BypassInput ValidationOn-Device AIApple Intelligence
8 項對應的 AIDEFEND 防禦手法
來源: Is That a Bad Apple in Your Pocket? We Used Prompt Injection to Hijack Apple Intelligence 
作者: Petros Efstathopoulos, PhD, Laura Koetzle, Dario Pasquini, PhD
原文發布: 2026年4月9日

威脅分析

  • 攻擊目標是 iOS 與 macOS 由作業系統代管的本機大語言模型。 Apple Intelligence 透過 Foundation Models framework 開放 app 呼叫裝置上的 LLM,所以第三方 app 不需要碰到模型權重或執行期,也能把資料送進系統級模型處理。
  • 這個繞過方式分成兩步。 第一步是用 Neural Exec 這類對抗輸入,把模型帶往攻擊者想要的任務。第二步是把攻擊內容混進 Unicode RLO 這種會改變文字顯示順序的字元裡,讓畫面上看到的文字順序和底層真正送進模型、過濾器的內容不完全一樣。這樣輸入與輸出過濾器就更難判斷真正的攻擊內容。
  • 成功率不低。 RSAC 的研究人員表示,在 Apple 強化前,他們用 100 個隨機提示詞(prompt)測試,平均攻擊成功率達 76%。
  • 健康與媒體資料是可能的影響,並非已證實的外洩事件。 RSAC 提出:RSAC 提出:如果一個健康 app 能讀取使用者的健康紀錄,被帶偏的模型就可能把這些資料整理、摘要或外洩出去;如果是健身或影片編輯 app,攻擊者可能誘導模型改掉訓練計畫、產生錯誤建議,或操作該 app 原本就有權處理的媒體內容。
  • 平台已發布強化版本。 Apple 已在 iOS 26.4 和 macOS 26.4 修正受影響系統;使用者應升級。app 團隊在開發時,也應該限制哪些資料可以送進本機模型,以及模型回覆可以觸發哪些 app 功能。
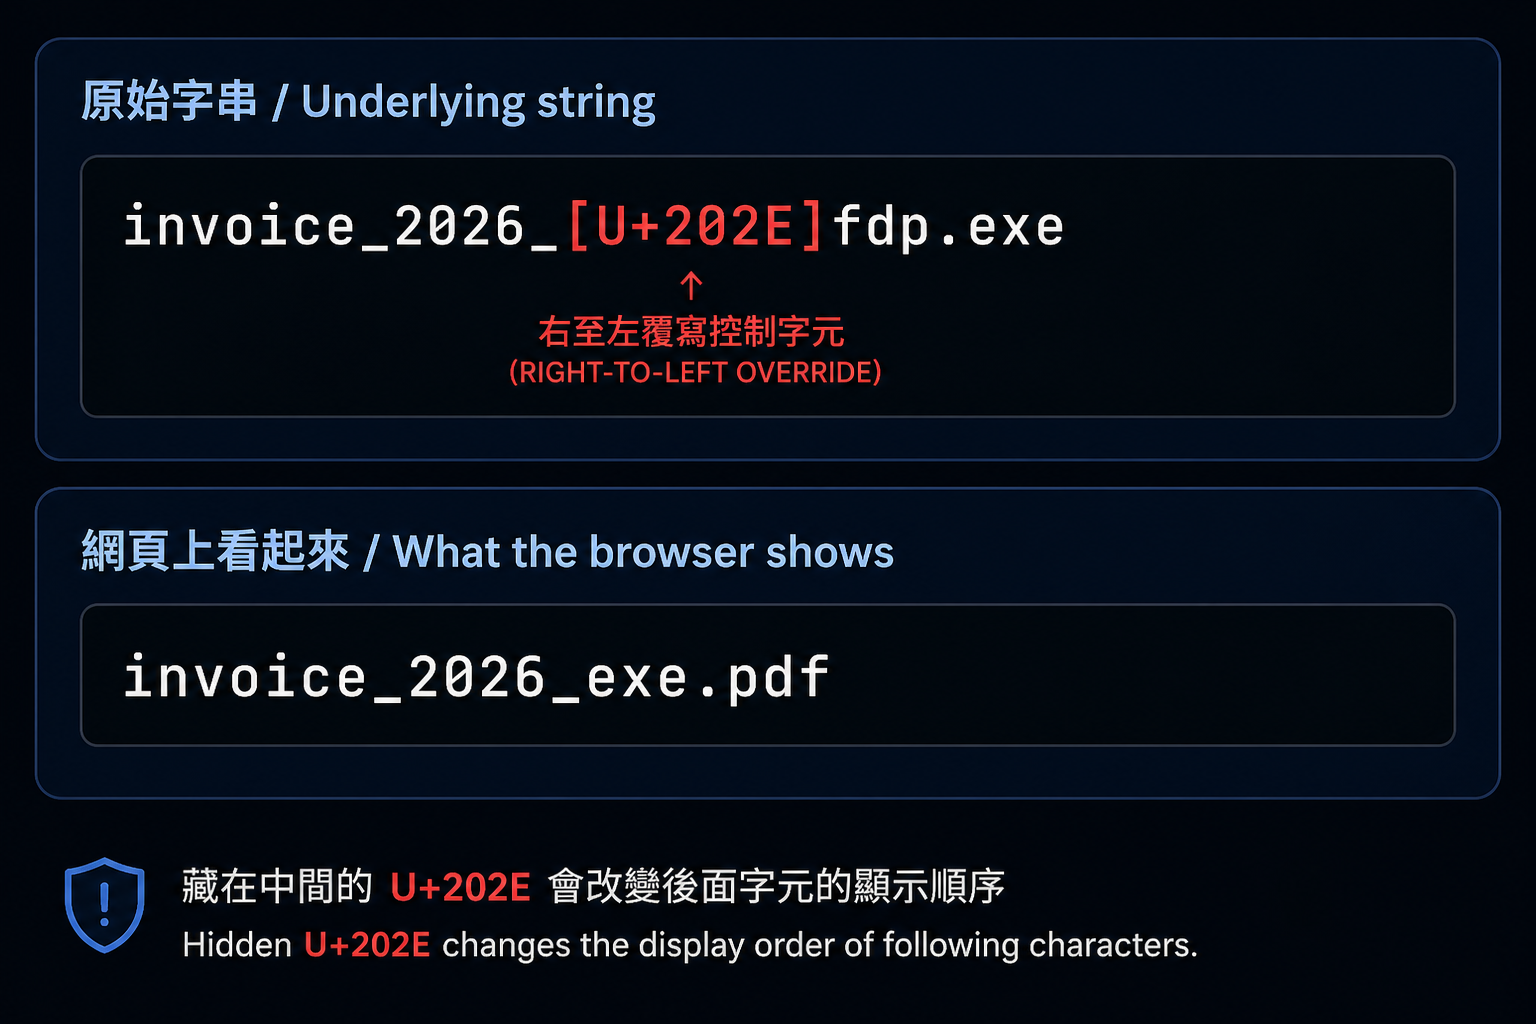
RLO 顯示順序示意:底層字串 invoice_2026_[U+202E]fdp.exe 仍包含 .exe,畫面卻可能看起來像 invoice_2026_exe.pdf。
這張圖在示意:藏在字串裡的 U+202E 會改變後面字元的顯示順序。底層字串仍然包含 .exe,但畫面上可能看起來更像安全的 .pdf 檔名。

適用的 8 項 AIDEFEND 防禦手法

AID-H-002.002
Inference-Time Prompt & Input Validation
高
在 app 可控制的推論入口,依 G002 的版本化欄位規則,在組裝提示詞前拒絕 RLO 與其他不允許的格式字元。應保留合法多語文字與程式碼的原意;偵測用的簡化文字,不能取代模型實際讀入的內容。偵測器與模型必須綁定同一份放行內容與政策。這能限制本案的 RLO 載體,但不保證辨識 Neural Exec 或所有語意轉向,app 也無法自行修補平台模型。
AID-H-018.004
Intent-Based Dynamic Capability Scoping
高
在可控制的工具派送位置,取呼叫者、工作負載、工具登錄資料與另行核准任務權限的交集,並檢查具簽章的權限範圍、期限與不可被並行呼叫繞過的動作次數上限;須包含 G002 的可信登錄資料與外部稽核驗證。不可信內容只能縮小權限,不能新增工具。這能拒絕範圍外的呼叫,但不會自動阻止既有允許工具遭到濫用,或任務範圍內的惡意回答。其他執行路徑也須實測涵蓋;列出此技術不代表代管平台已落實。
AID-H-003.010
Deployed AI Software Vulnerability Remediation Lifecycle
高
把受影響的 Apple Intelligence 裝置納入 AI 軟體修補流程:分階段部署已強化的作業系統版本、保留回復能力,並逐一確認端點實際執行的版本。RSAC 記錄的是平台強化,沒有另外指出 Neural Engine 漏洞。完成裝置群修補與驗證提示詞、輸出關卡,是不同工作。
AID-I-007
Client-Side AI Execution Isolation
高
模型跑在使用者裝置上,所以隔離仍然很重要,即使模型由作業系統管理也一樣。每個 app 都應該待在自己的沙箱裡;app 之間如果要傳資料或呼叫功能,也要經過受控管的本機溝通機制和權限檢查。這樣就算本機模型被帶偏,也比較不會讓 A app 借模型讀到 B app 的資料,或觸發 B app 原本不該被它觸發的功能。
AID-M-009.002
Authority Envelope & Action Risk Classification
高
將改動 app 可存取的健康資料、媒體或其他使用者內容,列為高風險動作。權限與風險紀錄應明列哪些動作需要確認、拒絕或縮小資料範圍,再交由執行時的工具授權與資料使用關卡落實;分類紀錄本身不會阻止動作。
AID-H-006.002
Text, Markup & Structured Output Sanitization and Release Gate
中
模型輸出顯示給使用者或交給 app 邏輯前,必須經過該輸出位置專用的放行檢查。只做 HTML 跳脫,仍會保留 RLO,無法消除誤導性的顯示順序。需另行實作並驗證 Unicode 顯示介面,依輸出政策把不允許的控制字元顯示為可見碼點,或拒絕放行;已公開的 G001 HTML/程序參數範例沒有實作此功能。動作授權仍須另外檢查。
AID-D-001.001
Per-Prompt Content, Intent & Obfuscation Analysis
中
在營運者可控制的入口,依 G001 使用鎖定版本、經校準的次要分類器,檢查 app 可控制的推論介面實際送入模型的文字中的任務轉向、權限宣稱或提權意圖,並產生與確切內容綁定的發現。RLO 與呈現後文字的比對,需要另行實作 Unicode/顯示處理介面;G001 沒有提供這項功能。分類結果提供證據,是否拒絕輸入由獨立放行政策決定;看似合理或被隱藏的指令仍可能漏判。放行前須另行驗證完整分類結果與必要類別的涵蓋範圍。目前 G001 範例會把空結果、缺少必要類別或NaN 分數回報為 PASS/NO_FINDING;整合端必須把這些情況視為錯誤並拒絕放行。這是額外需要實作的檢查,不是已公開範例原本就具備的行為。
AID-H-029.002
Lifecycle-Stage Authorization Gate
中
app 資料進入推論脈絡前,確認確切版本與可信的階段/用途標記;授權缺漏、撤回或過期時拒絕使用。這項檢查與 app 權限、呼叫者及物件存取授權分開,G001 不實作後者。列出此技術不代表平台目前已提供該閘門,也無法阻止已核准供相同階段與用途使用的資料遭到濫用。

身為資安防禦者,我們應該這麼做

  • 將受管 Apple 裝置升級至 iOS 26.4、macOS 26.4 或更新的適用修補版本,並確認實際執行版本;來源未證明所有裝置都已完成更新。
  • 盤點使用 Apple Intelligence 或 Foundation Models 框架的 app,分類每個 app 可提供給本機模型的資料與功能。
  • 在組裝提示詞前套用欄位專用的 Unicode 規則,拒絕不允許的 RLO 等控制字元,並保留合法多語文字與程式碼。不要把偵測用的簡化文字改當成模型輸入。
  • 分別測試原始輸出、實際顯示及 app 動作參數;需要人確認時,讓隱藏碼點可見。HTML 跳脫不能單獨處理雙向文字顯示風險。
  • 將本機模型可呼叫的工具限制在已核准任務內;敏感資料讀取或改動狀態的動作,仍需獨立的物件授權與執行時檢查。

1 個額外的防禦考量

本機 LLM app 的端點層級權限透明度

除了上面對應的 agent 與 skill 權限控制,平台與企業端點管理層也應該看得見每個本機 LLM app 的實際活動:哪些 app 會呼叫裝置上的模型、連到哪些本機服務、讀寫哪些路徑、能碰到哪些 API key 或 token,以及模型輸出可以影響哪些 app 動作。
建議做法: 在 app review、MDM、隱私設定和端點資產清單中揭露 AI 權限 manifest;讓管理員能阻擋本機 LLM 存取高機敏資料類別;並要求 app 說清楚模型輸出是否能改動檔案、健康紀錄、媒體、訊息或其他使用者內容。

結論

這個案例提醒我們,本機 AI 也會影響整個平台的安全。模型跑在裝置上,確實能降低一部分雲端曝險,但它也因此更靠近 app 資料、使用者檔案和作業系統代管功能。AIDEFEND  對應到的防線包括:先清理模型輸入、驗證模型輸出、限制每個 app 能交給模型的資料和可觸發的功能、隔離 client 端執行環境,以及在高機敏資料被使用前加上授權關卡。實務目標很清楚:就算本機 LLM 被帶偏,它也只能拿到應該有的權限、處理必要資料、執行原本被允許的功能,而不是變成攻擊者操作 app 或資料的入口。

最後更新: